
糖基化修饰就像蛋白质的“身份证”,调控着细胞识别、免疫应答等关键生命过程。但想看清这张“身份证”上的糖链结构,科学家们一直面临两大难题:一是O-糖链种类太多、缺乏数据库;二是不同质谱仪器的数据格式不统一。现在,这个困局有望被打破。加拿大滑铁卢大学李明院士团队与清华长三角研究院邓海腾团队合作,在《自然·通讯》(Nature Communications)上在线发表题为《多种碎裂技术下 N-连接与 O-连接糖肽的糖链高精度从头预测》“High-accuracy glycan de novo prediction for N- and O-linked glycopeptides across multiple fragmentation techniques”的研究论文,双方团队成功开发DeepGlycan算法,在不依赖糖链数据库的情况下,对N-连接和O-连接糖肽进行高精度从头测序,并兼容sceHCD、EThcD等多种质谱碎裂技术,为复杂糖基化的系统解析和疾病相关标志物发现提供了新工具。
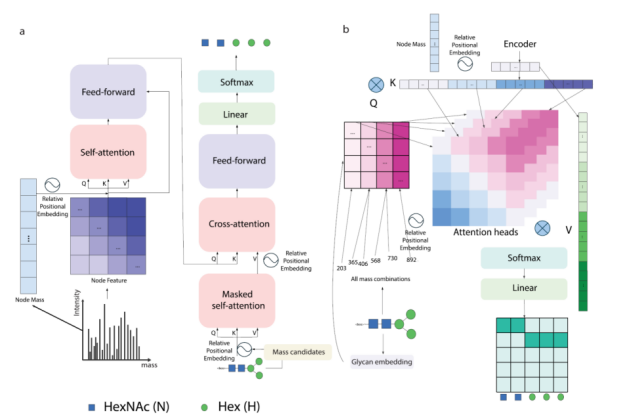
* DeepGlycan 的工作流程与模型架构
糖基化是蛋白质最重要的翻译后修饰之一,能够广泛参与蛋白质折叠、稳定性、分布、细胞信号转导和免疫应答等过程。研究蛋白质上的糖链修饰,是理解糖基化功能的关键。糖基化研究意义重大,糖肽分析却长期面临挑战。N-糖链具有相对保守的核心结构,而O-糖链核心结构多样,已知结构和可靠谱图匹配数量较少;同时,不同碎裂技术产生的质谱图模式差异明显。现有糖基化从头测序算法多针对N-糖基化和sceHCD数据设计,敏感性和适用范围有限,难以满足跨糖基化类型、跨碎裂技术的实际分析需求。
为突破这一瓶颈,研究团队开发了DeepGlycan算法。该算法采用Transformer编码器-解码器架构:先将质谱中的每个峰转化为候选碎片离子节点,编码电荷、离子类型和强度等信息;再利用旋转位置编码学习节点间的质量差,识别单糖单元;最后以自回归方式逐步推断糖链组成。模型在EThcD N-糖肽数据上训练后,可迁移至sceHCD数据,并直接用于O-糖链的零样本预测。DeepGlycan可直接从质谱数据分析N-连接和O-连接糖肽的糖链组成,兼容sceHCD、EThcD等多种碎裂技术,并能发现已知糖基化数据库之外的糖链。在sceHCD N-糖肽数据上,其糖链召回率和精度分别达96.80%和98.53%,优于pGlycoNovo、StrucGP和GlycoNovo等工具;在O-糖链零样本预测中同样保持高精度。研究还通过合成O-糖肽标准品和神经氨酸酶处理,验证了其在小鼠心脏组织中鉴定到的新型O-糖肽。
该研究为糖蛋白质组学提供了开放、可发现未知修饰的从头解析工具,使低丰度、未充分表征的糖链得以系统挖掘,并可扩展下游数据库搜索和定量分析,为肿瘤、自身免疫病、阿尔茨海默病等疾病相关糖基化机制和标志物研究提供新手段,推动糖基化分析从数据库检索向开放发现的发展。
该论文共同第一作者为加拿大滑铁卢大学张千秋、毛泽平和清华大学生命科学学院陈宇凌;共同通讯作者为清华长三角研究院邓海腾教授和加拿大滑铁卢大学李明教授。
研究得到国家重点研发计划、国家自然科学基金、北京市自然科学基金、加拿大自然科学与工程研究理事会及人类蛋白质组导航计划等项目的支持。
原文链接:https://doi.org/10.1038/s41467-026-76701-2